Halucynacje AI: dlaczego chatbot zmyśla i jak ograniczyć zmyślanie
Halucynacje AI to odpowiedzi, które brzmią pewnie i wyglądają na prawdziwe, a są zmyślone. Dwunastego maja 2026 roku niemiecki sąd w Hamm uznał, że za takie zmyślenia chatbota na stronie odpowiada firma, która go uruchomiła. Poniżej: dlaczego model zmyśla, jak ustawić asystenta w sklepie i jak pracować, żeby takich odpowiedzi było mało.
- Wyrok z Hamm
- Sobota, dwudziesta druga
- Tokeny: jak model czyta tekst
- Adresy znaczeń, uwaga i następne słowo
- Dlaczego AI zmyśla pewnym tonem
- Jak ograniczyć halucynacje AI
- Asystent AI na stronie sklepu
- Pamięć, okno kontekstu i przerwy
- Pięć zasad
- Częste pytania
- Źródła
Wyrok z Hamm
Firma oferująca zabiegi medycyny estetycznej postawiła na swojej stronie chatbota, który odpowiadał na pytania i umawiał wizyty. Zapytany o kwalifikacje dwóch lekarzy prowadzących firmę, chatbot przypisał im specjalizację z chirurgii plastycznej i estetycznej, której nie mieli. Sprawę wniosła organizacja konsumencka (Verbraucherzentrale NRW).
| Co | Szczegóły |
|---|---|
| Sąd i data | Wyższy Sąd Krajowy w Hamm, 12.05.2026, sygn. 4 UKl 3/25 |
| Odpowiedź chatbota | „A und B sind Fachärzte für plastische und ästhetische Chirurgie” (według orzeczenia) |
| Podstawa wyroku | niemiecka ustawa o zwalczaniu nieuczciwej konkurencji (UWG): błędna odpowiedź chatbota była wprowadzającą w błąd praktyką handlową firmy |
| Wniosek sądu | to, co mówi chatbot firmy, mówi firma |
Wyrok nie opisuje, skąd chatbot wziął te tytuły. Mechanizm, który mógł je podsunąć, działa w każdym modelu i opisuję go niżej.
Sobota, dwudziesta druga
Przykład do reszty tekstu: sklep z kawą i młynkami (dane fikcyjne). Od miesiąca na stronie odpowiada asystent AI, bo klienci piszą wieczorami, kiedy nikt nie dyżuruje. W sobotę o 22:00 klientka pyta, czy młynek Ziarno 200 ma ceramiczne żarna i czy może go oddać po miesiącu. Asystent odpowiada od razu i bardzo uprzejmie: tak i tak.
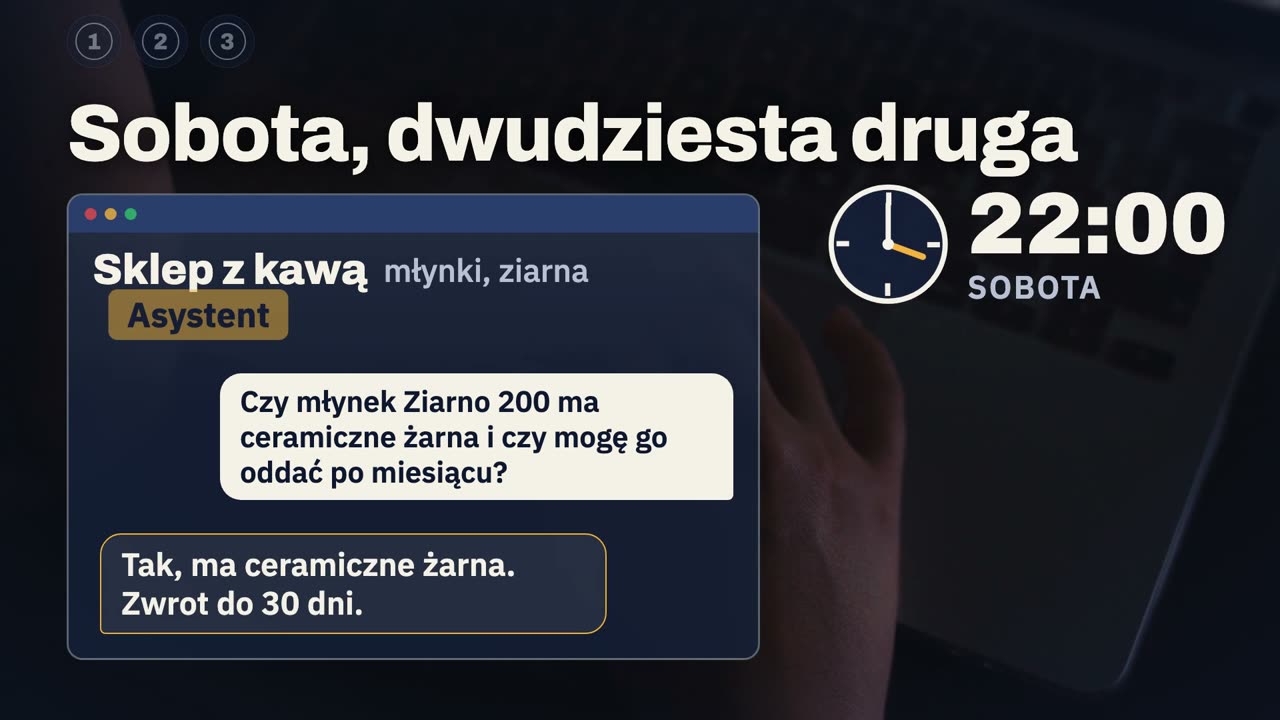
Młynek ma żarna stalowe, a regulamin mówi o 14 dniach. W poniedziałek przychodzi mail z prośbą o zwrot po trzech tygodniach i ze zrzutem ekranu z rozmowy. Możesz się spierać albo przyjąć zwrot, ale klientka ma czarno na białym, co obiecał Twój sklep. Ważniejsze pytanie brzmi: skąd asystent to wziął, skoro nikt mu tego nie napisał.
Tokeny: jak model czyta tekst
Model nie czyta tekstu tak jak Ty. Najpierw kroi go na tokeny, czyli krótkie kawałki, z których każdy ma swój numer. Polskie słowo „przygotuj” to kilka takich kawałków, angielskie „prepare” jeden.
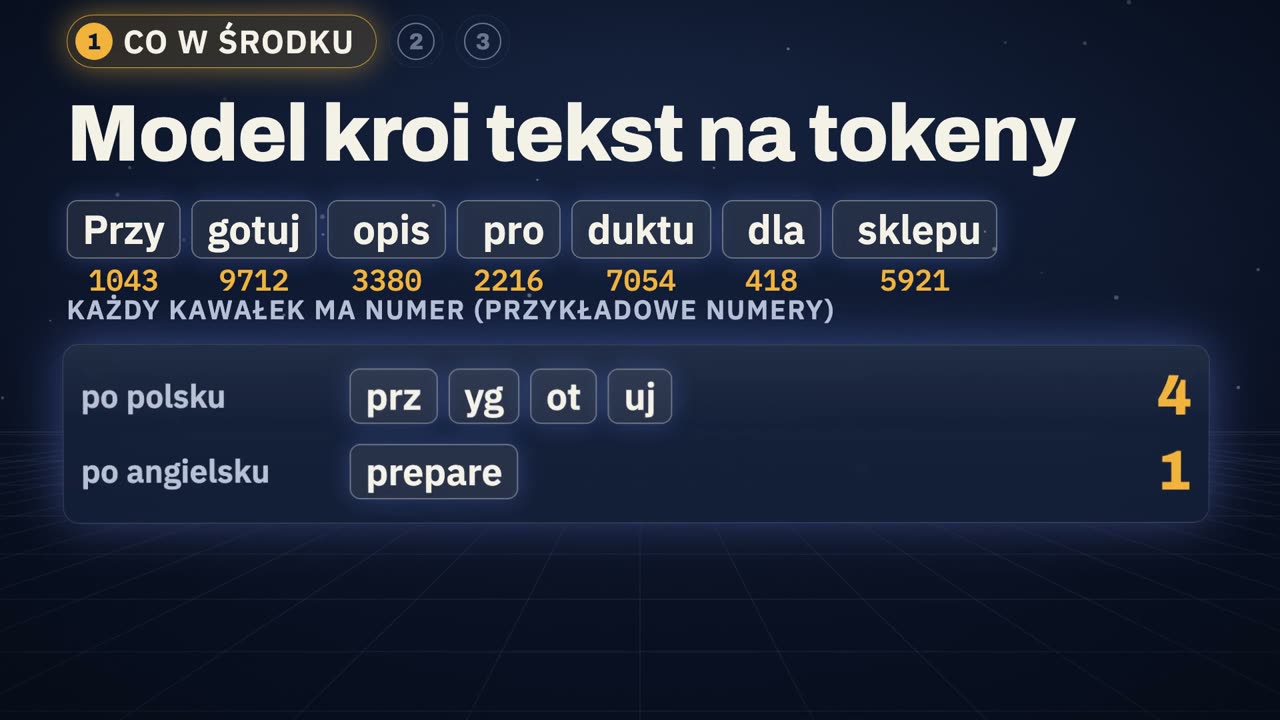
W tokenach liczy się wszystko: ile model widzi naraz, ile kosztuje odpowiedź i ile zostało limitu. Ten sam tekst w różnych językach kroi się na różną liczbę tokenów, a polski zwykle na więcej niż angielski. Badacze z Oksfordu pokazali, że ta różnica przekłada się na koszt i na to, ile treści zmieści się w jednej rozmowie.
W praktyce nie wklejaj tego samego dokumentu kilka razy w jednej rozmowie. Stały materiał trzymaj w projekcie, czyli w folderze w aplikacji, gdzie łatwo go podmienić na aktualny. Jak oszczędzać limit, opisuję w osobnym materiale: limity w Claude.
Adresy znaczeń, uwaga i następne słowo
Każdy token zamienia się w ciąg liczb, który działa jak adres w sklepie: alejka, regał, półka. W supermarkecie mleko nigdy nie stoi obok wiertarki. Nabiał ma swoją alejkę, narzędzia swoją. Model układa znaczenia podobnie: słowa o zbliżonym sensie dostają bliskie adresy. Dlatego na prośbę o coś do smarowania pieczywa model trafia między masło a twarożek, choć nie padło słowo „masło”.
Drugi element to mechanizm uwagi. Każde słowo zagląda w tekst, który stoi przed nim, i szuka tego, co je wyjaśnia.
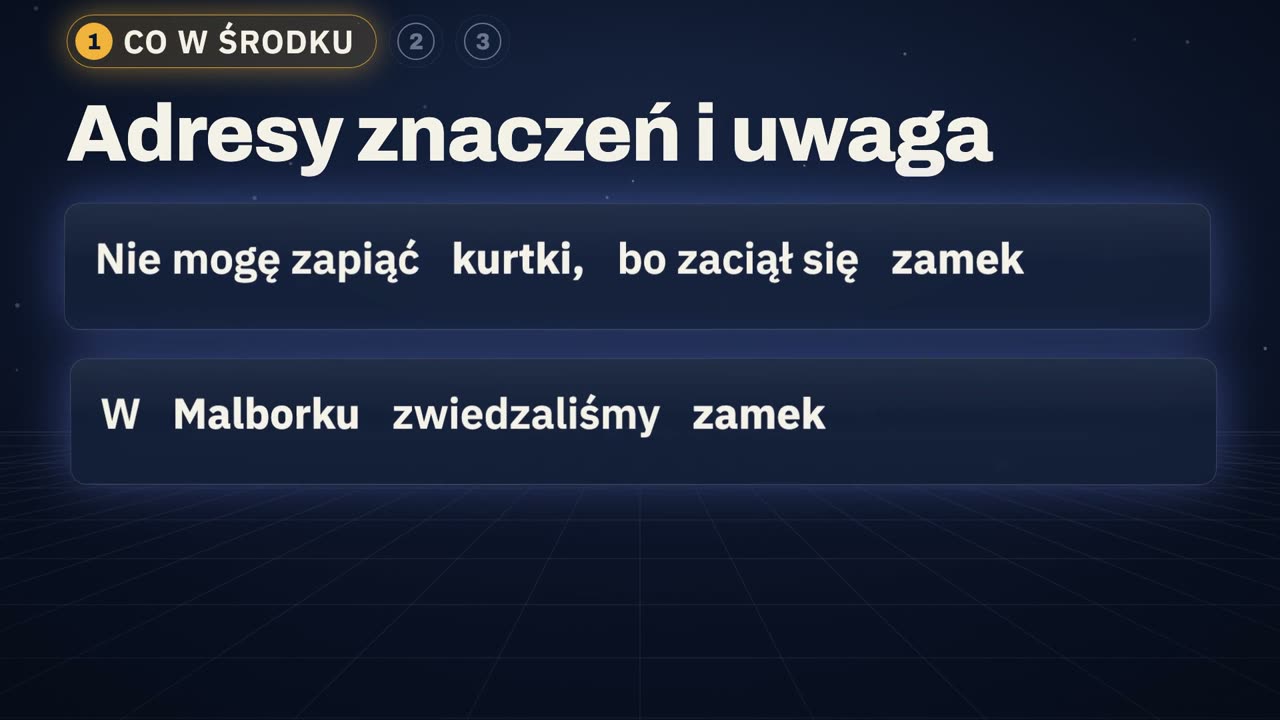
Po wielu takich krokach model ocenia, jakie słowo powinno pojawić się dalej. Weź przycisk „Dodaj do”: „koszyka” ma ogromną szansę, „ulubionych” czy „porównania” dużo mniejszą. Model bierze mocnego kandydata, dopisuje go i dla dłuższego tekstu znów ocenia, co dalej. Tak, kawałek po kawałku, rośnie cała odpowiedź.
Przy zdaniu „Ten produkt jest idealny dla” pasuje wiele zakończeń: rodzin, każdego, aktywnych, początkujących. Model nie zawsze bierze kandydata z samej góry, czasem losuje spośród kilku mocnych. Dzięki temu teksty brzmią naturalnie, ale to samo pytanie daje różne odpowiedzi.
I tu wraca sobotni asystent. Jeśli w tekstach, na których się uczył, przy dobrych młynkach często padały ceramiczne żarna, to po słowach „młynek ma żarna” właśnie „ceramiczne” ma dużą szansę. Model nie sprawdza Twojej karty produktu. Dopisuje to, co pasuje.
Skąd model wie, które słowo pasuje? Z treningu, który w uproszczeniu ma dwa etapy. W pierwszym model przypomina ucznia z kluczem odpowiedzi: zasłania następne słowo, zgaduje je, odsłania i się poprawia, przez miliardy zdań. Taki model świetnie dopisuje tekst, ale słabo wykonuje polecenia. Dopiero drugi etap, na przykładach dobrych odpowiedzi i ocenach ludzi, robi z niego asystenta, który odpowiada na pytania i trzyma się instrukcji.
Przy zadaniach, które mają wyglądać zawsze tak samo, daj modelowi wzór wyniku. Wzór trzyma format, choć słowa i tak będą się trochę różnić. Przykład wzoru dla opisu produktu:
Jak zastosować wzór w opisach produktów, pokazuję w materiale opis produktu z AI.
Dlaczego AI zmyśla pewnym tonem
Model składa odpowiedź z tego, co pasuje, i nie ma w sobie odruchu sprawdzania. Zapytany bez źródła o cenę, przepis albo datę, może podać coś, co tylko wygląda jak prawdziwa cena, przepis albo data. I zrobi to tym samym pewnym tonem co przy faktach. W sklepie wygląda to zwyczajnie:
- parametr, którego produkt nie ma,
- termin zwrotu wzięty z innego sklepu,
- przepis, który brzmi poważnie, choć takiego nie ma,
- link do strony, która nigdy nie istniała.
Tak mogły powstać tytuły z Hamm: brzmiały jak prawdziwe, bo pasowały do zdania o lekarzach. Nabierają się na to nawet ci, którzy powinni wiedzieć lepiej. Prawnik Damien Charlotin prowadzi bazę spraw sądowych, w których ktoś złożył pismo ze zmyśleniami AI. Na koniec października 2026 jest ich ponad 2200 na świecie, z czego ponad 1500 w Stanach Zjednoczonych. Samego 23 października trzy amerykańskie sądy trafiły na pisma powołujące się na wyroki, których nie ma.
Jest jeszcze jeden powód. Badacze OpenAI opisali, że testy, na których ocenia się modele, punktują zgadywanie, a odpowiedź „nie wiem” daje zero punktów. Dlatego model może nie powiedzieć, że czegoś nie wie, dopóki wprost mu na to nie pozwolisz. Google pisze w wytycznych dla stron, że modele generatywne nie wyszukują faktów, tylko przewidują prawdopodobny ciąg słów.
Jak ograniczyć halucynacje AI
Kiedy model pracuje na Twoich dokumentach albo ma włączone wyszukiwanie, ma się na czym oprzeć. Pomaga też jedno zdanie w poleceniu, dzięki któremu „nie wiem” przestaje być porażką i staje się częścią zadania.
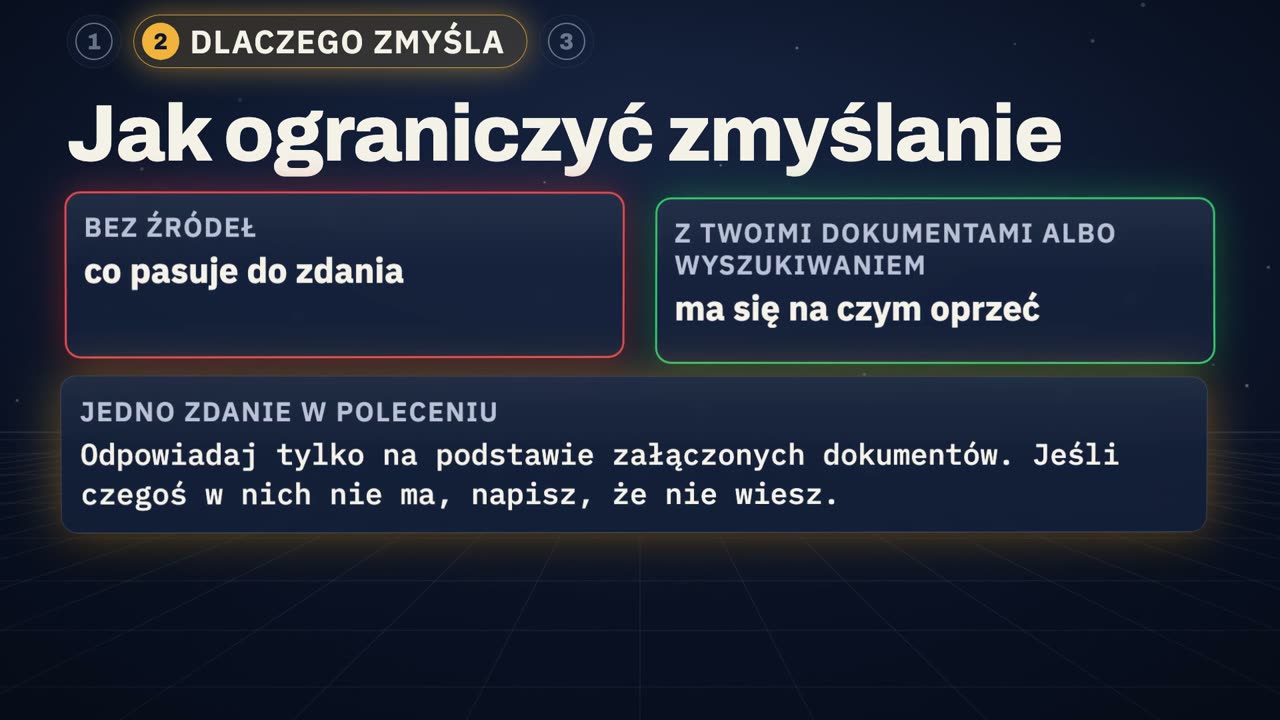
Odpowiadaj tylko na podstawie załączonych dokumentów. Jeśli czegoś w nich nie ma, napisz, że nie wiesz.
Model nadal może się pomylić, więc fakty, ceny i przepisy sprawdzaj w źródle. Przyda się też druga para oczu: otwórz nową rozmowę albo inny model i daj mu wynik z listą rzeczy do sprawdzenia. Świeże spojrzenie może wyłapać to, czego model w tej samej rozmowie nie zauważy.
Sprawdź poniższy tekst jako recenzent. Wypisz każde twierdzenie, które wymaga sprawdzenia w źródle: liczby, ceny, przepisy, daty, nazwy. Przy każdym napisz, czy da się je potwierdzić na podstawie tego tekstu. Tekst: …
Asystent AI na stronie sklepu
Asystent na stronie działa na tym samym mechanizmie, więc sam z siebie nie przestanie zgadywać. Możesz za to zmienić to, na czym się opiera. Cztery ustawienia:
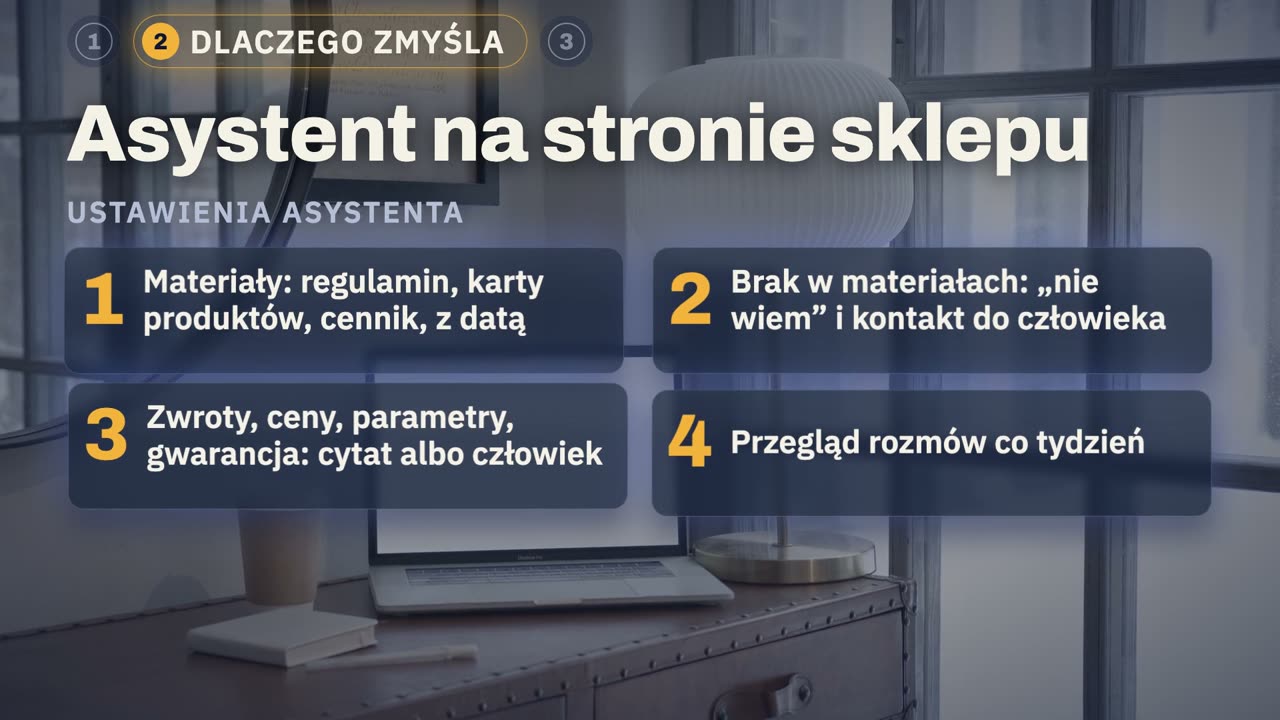
- Materiały. Daj asystentowi dokumenty, z których ma odpowiadać: regulamin, karty produktów i cennik, z datą w nazwie pliku. Podmieniaj je, gdy coś się zmienia.
- „Nie wiem”. W instrukcji napisz, że jeśli odpowiedzi nie ma w materiałach, asystent mówi wprost, że nie wie, i podaje kontakt do człowieka.
- Tematy, w których błąd kosztuje. Zwroty, ceny, parametry i gwarancję asystent obsługuje tylko na podstawie dokumentu albo przekazuje dalej.
- Przegląd rozmów. Raz w tygodniu przeczytaj rozmowy z tych tematów. Nawet dobrze ustawiony asystent czasem się pomyli, a Ty dowiesz się o tym przed klientem, nie po.
Odpowiadaj wyłącznie na podstawie załączonych materiałów: regulaminu, kart produktów i cennika. Jeśli odpowiedzi nie ma w materiałach, napisz, że nie wiesz, i podaj kontakt do obsługi sklepu. Przy pytaniach o zwroty, ceny, parametry i gwarancję zacytuj odpowiedni punkt dokumentu albo przekaż sprawę człowiekowi.
Po takiej zmianie ta sama klientka dostaje odpowiedź w rodzaju: „Ziarno 200 ma żarna stalowe. Zwrot do 14 dni, regulamin pkt 7.” Wyrok z Hamm zapadł w Niemczech, ale jego logika jest prosta: klient rozmawia z Twoją firmą, a nie z modelem. Jak zbudować własnego asystenta, pokazuję w materiale agent AI.
Pamięć, okno kontekstu i przerwy
Model nie ma pamięci, aplikacja coraz więcej
Model nie ma pamięci między wiadomościami. Każdą odpowiedź pisze tak, jakby widział rozmowę pierwszy raz. Za każdym razem, gdy klikasz „Wyślij”, aplikacja składa paczkę: Twoją wiadomość, dotychczasową rozmowę, instrukcję projektu i potrzebne fragmenty plików. Projekt to miejsce w aplikacji, w którym trzymasz stałe instrukcje i pliki dla wielu rozmów.
Dziś do paczki trafia coś jeszcze: pamięć, którą aplikacja zapisuje sama. Claude i ChatGPT notują w trakcie rozmów, co uznają za przydatne o Tobie i Twojej pracy, i dokładają to do kolejnych rozmów. To wygodne, ale pamięć sama decyduje, co zapisać. Co z tym zrobić:
- zasady, których model ma się trzymać zawsze, wpisz do instrukcji projektu,
- raz na jakiś czas zajrzyj w ustawieniach, co aplikacja o Tobie zapamiętała, i usuń to, co nieaktualne,
- gdy pracujesz nad czymś, czego nie chcesz w pamięci, użyj czatu tymczasowego, który do niej nie trafia.
W Claude pamięć jest domyślnie włączona w planach dla pojedynczych osób, a każdy projekt ma własną, oddzieloną od reszty. W ChatGPT strona pomocy nie podaje domyślnego stanu pamięci dla kont prywatnych, więc sprawdź go u siebie w ustawieniach. Porównanie projektów w trzech narzędziach znajdziesz w materiale projekty w ChatGPT, Claude i Gemini.
Okno kontekstu i długie rozmowy
Największy możliwy rozmiar paczki to okno kontekstu. Wyobraź sobie biurko z teczkami: instrukcje, pamięć, rozmowa, pliki, Twoje nowe pytanie. Im więcej teczek, tym łatwiej przeoczyć te ze środka (opisują to badania Liu i in., „Lost in the Middle”, 2023). Gdy biurko jest pełne, aplikacja streszcza starsze teczki albo prosi o nową rozmowę.
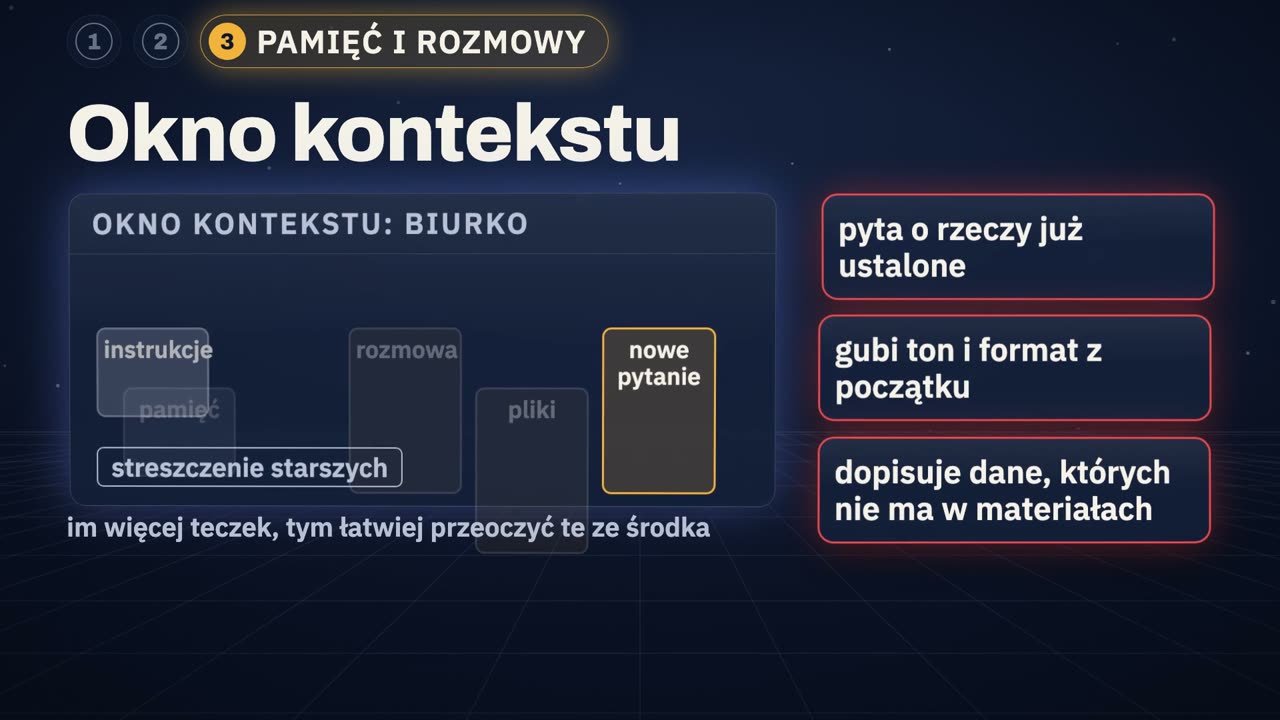
Objawy znasz. Model pyta o rzeczy już ustalone, gubi ton i format z początku, zaczyna dopisywać dane, których nie ma w materiałach. Poprawianie polecenia pomaga na chwilę. Na dłużej pomaga notatka i nowa rozmowa: nowa rozmowa dostaje wtedy wszystko, co ważne, i nic z tego, co już nieaktualne.
Zapisz w punktach, co ustaliliśmy, z jakich plików korzystamy i co jest następnym krokiem.
Zapisz tę notatkę, otwórz nową rozmowę i zacznij od niej. Jeden temat, jedna rozmowa.
Przerwa w rozmowie kosztuje
W narzędziach, które liczą limit w ilości przetworzonego tekstu, tak jak Claude, każda wiadomość w długiej rozmowie zużywa więcej limitu, bo paczka jest większa. Część paczki serwer potrafi trzymać pod ręką i liczyć taniej: materiały projektu, a w narzędziach dla programistów także powtarzany początek rozmowy, domyślnie przez kilka minut. Po dłuższej przerwie albo po zmianie instrukcji ta oszczędność znika i cała paczka liczy się od nowa. Zasada: po długiej przerwie albo przy nowym temacie nie wracaj do starej, długiej rozmowy. Zapisz stan i zacznij nową, krótką.
Pięć zasad
- Fakty, ceny i przepisy sprawdzaj w źródle.
- Asystent dla klientów odpowiada z Twoich dokumentów i mówi „nie wiem”.
- Stałe zasady trzymaj w instrukcji projektu, a pamięć aplikacji przeglądaj.
- Jeden temat, jedna rozmowa; po przerwie nowa, od notatki.
- Przy powtarzalnych zadaniach daj wzór wyniku.
Częste pytania
Czym są halucynacje AI?
To odpowiedzi, które wyglądają jak prawdziwa cena, przepis albo data, a są zmyślone. Model składa odpowiedź z tego, co pasuje do zdania, i nie ma odruchu sprawdzania.
Dlaczego AI zmyśla?
Model dopisuje słowo po słowie to, co najlepiej pasuje, i nie sprawdza faktów. Do tego testy, na których ocenia się modele, punktują zgadywanie, a odpowiedź „nie wiem” daje zero punktów.
Czy ChatGPT kłamie?
Model dopisuje słowo po słowie to, co pasuje. Zapytany bez źródła, poda zmyślenie tym samym pewnym tonem co fakt, więc ceny, przepisy i daty sprawdzaj w źródle.
Jak ograniczyć halucynacje AI?
Daj modelowi własne dokumenty albo włącz wyszukiwanie i dopisz do polecenia, że ma napisać „nie wiem”, gdy odpowiedzi nie ma w dokumentach. Fakty i tak sprawdzaj w źródle.
Kto odpowiada za błędną odpowiedź chatbota na stronie firmy?
Według wyroku z Hamm z 12.05.2026 firma, która uruchomiła chatbota. Sąd uznał, że to, co mówi chatbot firmy, mówi firma.
Dlaczego długa rozmowa z AI gubi ustalenia?
Im więcej treści w oknie kontekstu, tym łatwiej przeoczyć te ze środka. Zapisz w punktach ustalenia i zacznij nową rozmowę od tej notatki.
Źródła
Stan na listopad 2026. Sprawdzone 26.10.2026.
- Wyrok OLG Hamm z 12.05.2026, sygn. 4 UKl 3/25
- Library of Congress: omówienie wyroku (9.06.2026)
- Baza spraw sądowych ze zmyśleniami AI, Damien Charlotin
- OpenAI: Why language models hallucinate
- Google: wytyczne o treściach generowanych przez AI
- Liu i in.: Lost in the Middle (2023)
- Petrov i in.: tokeny w różnych językach (2023)
- Claude: pamięć
- ChatGPT: pamięć
Powiązane materiały
Bartosz Ratajewski. Ponad 20 lat w e-commerce i digitalu na stanowiskach dyrektorskich, dziś doradzam zarządom i właścicielom firm oraz szkolę z AI. Więcej o mnie · kanał na YouTube · brt@brt.pl